如果过去几年AI基础设施的关键词仅仅是更多的计算量,那么代理AI的大规模部署迫使行业面临一个更实际的问题:所有这些计算到底能有多高效地被利用?
在2026年Apsara大会上,H3C将问题以代币为主题提出。随着人工智能代理不断调用基础模型,万亿代币规模的服务正成为新的基础设施需求。
仅仅增加更多GPU并不一定能带来成比例的性能提升。空闲计算、网络拥塞、数据供应不足以及大规模集群的运行和故障挑战都可能侵蚀额外计算的价值。
这就是为什么H3C在本次活动中的产品阵容涵盖了多种技术,但遵循相对清晰的逻辑:从计算到网络和存储,从软件到运维,人工智能基础设施正从硬件堆栈向系统级优化迈进。
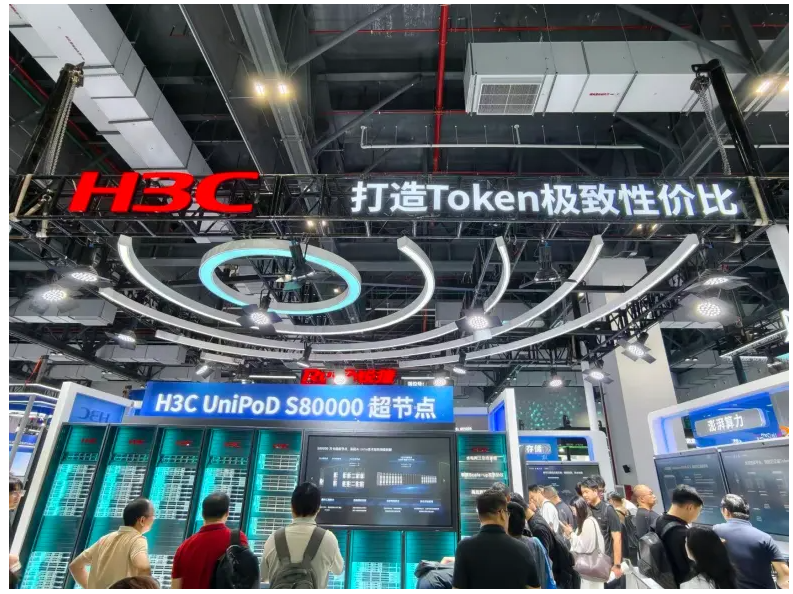
更多的GPU不一定意味着性能更好
惠3C先进技术研究部总经理朱世音将人工智能集群描述为高度集成的系统,需要硬件与软件紧密协调。
随着集群规模从数百个GPU增长到数千甚至数万个,GPU本身也只是方程式中的一部分。芯片间通信、数据传输、任务调度、电源供应和冷却都可能直接影响整体计算利用率。
H3C在活动中展示的UniPod S80000系列SuperPod正体现了这一理念。它支持32至1,024块GPU的配置,并可进一步扩展至16,384块GPU,同时支持包括CPU、GPU、NPU、DPU及主流框架在内的异构计算资源。
重点不仅仅是将更多芯片集成到单一系统,而是协调计算、网络、存储、云、安全和运维,使不同类型的计算资源能够作为统一系统进行管理。
换句话说,AI集群的竞争正在从系统拥有多少GPU转向每个GPU实际能产生多少有用的代币。
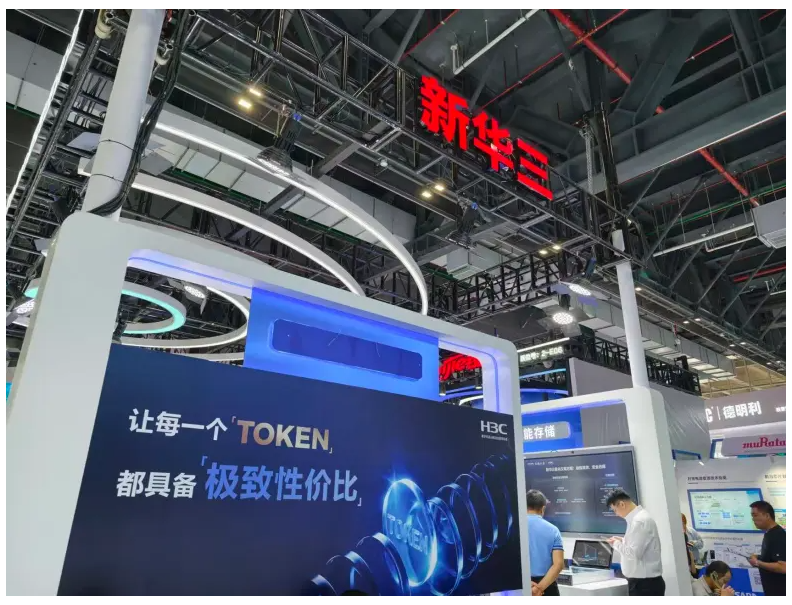
随着GPU速度的提升,网络可能成为瓶颈
朱教授还强调了高速互联,这是人工智能基础设施中日益重要的组成部分。原因很简单:随着GPU性能的提升,GPU之间交换的数据量也在增加。如果网络跟不上,GPU就只能等待。
这就是为什么H3C在活动中展示了三种互联场景:扩大规模、规模扩展和横向规模化。
在节点内,H3C推出了S9828-128EO,这是一款102.4特斯拉的NPO硅光子智能计算交换机,采用共封光学器件,将端到端延迟降低15%。节点方面,公司1.6T智能计算交换机S9828-64FP采用224G SerDes技术,在高密度环境中能将功耗降低20%以上,支持大规模集群扩展。
跨数据中心,800G智能计算DCI交换机S12500R-64EP设计支持城内跨数据中心计算调度和梯度同步。
这三层背后的逻辑归结为一个核心问题:随着AI集群的增长,互联如何避免成为计算性能的刹车?
互连也不再只是带宽的问题。随着集群的扩展,协议、拥塞控制、链路可靠性和故障诊断同样重要。如果厂商独立开发封闭的技术生态系统,可能会形成新的技术孤岛。开放协议和行业标准因此将变得越来越重要。
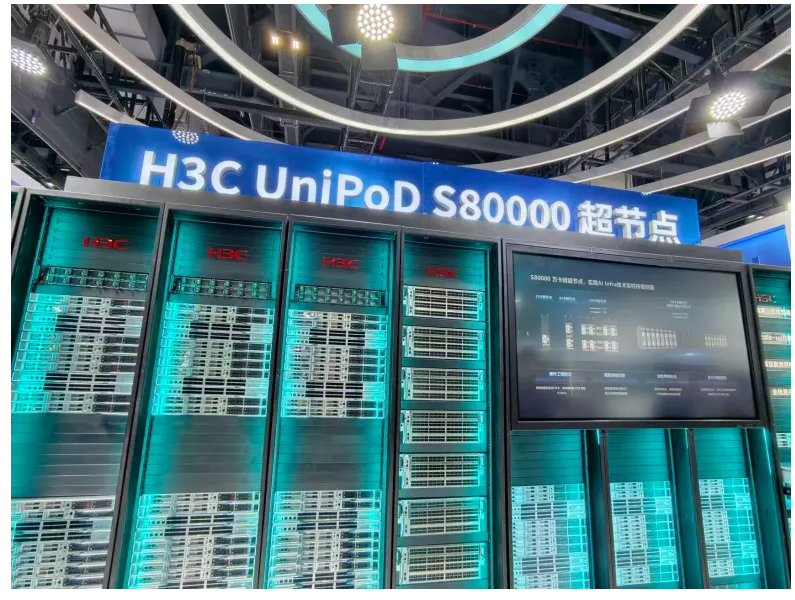
除了计算,还有另一个常被低估的挑战:数据
GPU没有数据就无法运行。在大模型训练中,数据准备、模型训练和参数交换都涉及大量数据流动。在推理过程中,KV Cache 进一步加大了对存储和缓存资源的压力。
因此,H3C也将高性能存储定位为更广泛的代币生产流程的一部分。其UniStor X20000系列X20836可提供最高200GB/s带宽和每节点300万IOPS,同时支持跨块、文件、对象和HDFS协议的互操作性。
据H3C称,其全速引擎可将GPU等待时间缩短30%,而XCache推理加速可在推理场景下将首次令牌时间延迟缩短多达90%。
结论相当实用:人工智能基础设施正从计算中心发展为全面的数据处理系统。从数据准备和培训到推理和代币生成,每一次等待期最终都转化为成本。
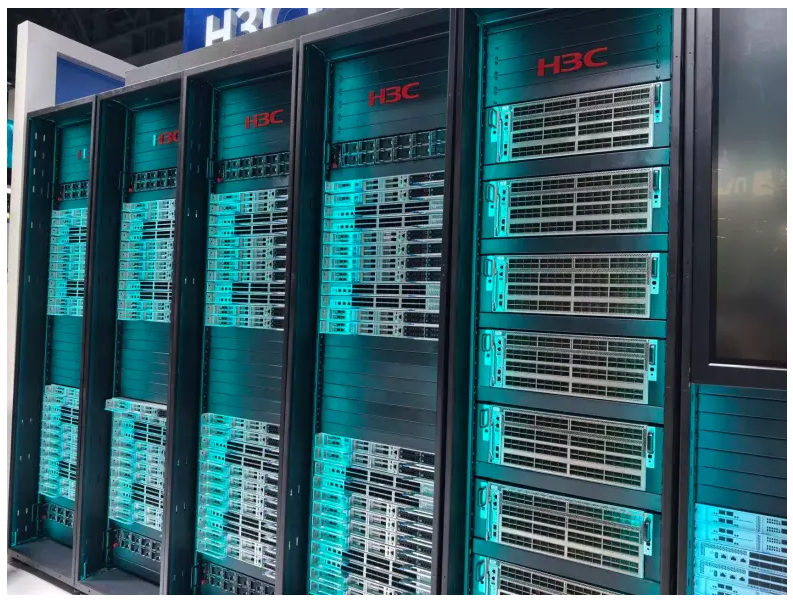
软件可能是下一个战场
一旦硬件达到一定规模,软件优化就变得越来越重要。朱博士指出,从操作系统和通信库到资源管理和调度平台,都需要与底层硬件紧密协作。
通信优化、计算与通信的重叠、任务调度、动态负载均衡以及统一资源管理,都能帮助减少GPU空闲时间和通信冲突。
这也是现代人工智能基础设施越来越像超级系统的原因。芯片提供计算,网络连接资源,存储提供数据,电力和散热则维持系统运行。而软件则负责将这些资源协调成一个运作良好的整体。
如果这些组件中的任何一个成为瓶颈,影响就不再局限于单一的硬件指标。它最终影响系统每秒能生成多少有用代币,以及每个代币产生的成本。
人工智能基础设施的下一阶段是计算利用率的竞争
从H3C的展台到Apsara大会的论坛会议,公司基本上从不同角度传达了同一观点。
超级节点解决了计算资源的大规模组织方式。高速网络解决了这些资源如何高效通信。高性能存储确保数据能够按时交付。软件、调度、运营和统一管理将这些资源转化为能够持续高效使用的人工智能能力。
因此,AI基础设施的下一阶段竞争可能不仅仅是谁拥有更多GPU。随着模型规模达到万亿参数规模,AI代理越来越多地调用基础模型,计算利用率、令牌吞吐量、延迟、能耗和每令牌成本等指标变得越来越重要。
这就是追求极致代币成本效益背后的深层含义:这不是要组装更多GPU,而是让系统中的每一个GPU、每个网络链路和每个存储单元都花更少等待的时间,多花更多时间工作。
随着人工智能进入大规模生产阶段,计算能力已不再只是芯片问题。这已成为一场对整个基础设施系统效率的竞争。
四川旭辉星创有限公司_四川省政采一体化框架协议入围、央采、成都市政采企业,信创产品方案解决商
欢迎访问网站:成都联想服务器总代理商 https://www.lxzdl.com/
欢迎访问网站:浪潮服务器代理商 https://www.lczdl.com/
欢迎访问网站:四川惠普服务器授权代理商 https://www.cditdl.cn/
欢迎访问网站:四川戴尔服务器金牌代理商 https://cditdl.com/
欢迎访问网站:四川H3C 华三服务器授权代理商 dell2026.com
欢迎访问网站:四川超聚变服务器授权理代理商cjbfwq.com
服务热线:13438344046 李丹(微信同号)

请用微信扫描二维码


